在前面一节中,我们首先讲解了关于爬虫的基本理论知识,然后带领大家动手写了一个入门级的爬虫程序--爬取心仪的妹子图,什么?你还不知道?赶快去看:写给小白看的爬虫系列之爬虫入门爬取妹子图 不知道大家消化的怎么样了,哈哈大家看到了自己心仪的妹纸吗?不过在前面一节中为了让大家更好的理解爬虫,采取了先易后难的策略,只爬取了一个网页的妹纸图,然后有的小伙伴觉得这不足以体现出对自己女神的热爱啊,要把我家女神全部的美图都抓取下来欣赏,好吧,现在就满足你对女神的全部幻想,本节带领大家在原来基础上爬取所有的相关网页的美图,让你一次看个够!想想还有点小激动呢?
在前面一节中我们讲过互联网上的网页存在很多的url链接,这些url可能相互指向,因此如果要爬取全部的url,我们需要知道哪些url已经被爬取过,哪些是新增加的url,在新增加的url所在的html中也可能存在新的指向其它网页的url,因此首先我们需要知道这些url的共同特点,即这些url的格式是怎样的,然后通过一个正则表达式来匹配这些url的格式,从而在html中搜索出相关的url。如图,我们打开http://iyangzi.com/?p=21,然后会看到当我们浏览完了该页面的全部美图之后,在页面的底部会存在2个指向其它页面的链接用来浏览上一页和下一页,类似于博客文章底部会搞一个上一篇,下一篇这样的跳转链接按钮一样,同样的,我们按F12,点击带箭头的光标,然后让右侧的源码区域自动定位到相应位置,我们可以看到该跳转链接为http://iyangzi.com/?p=10 ,如图
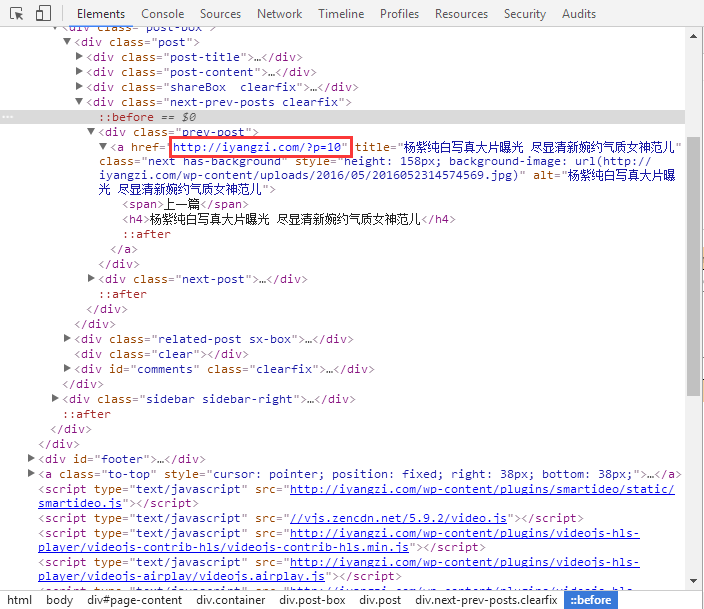
同样的我们可以多试几个页面,当然也可以直接点击这些链接,然后在浏览器的地址栏可以看到这些链接,最终可以发现跳转url的格式都是类似于http://iyangzi.com/?p=数字的形式,而且数字后面无其它内容,即是以数字结尾的,因此我们可以使用正则表达式来匹配这些具备类似格式的url,即
<code>http: // iyangzi.com /\?p =\d +$</code>
这样我们就可以从html中过滤掉不相关的网页的url,找出我们需要的url,然后将这些url添加到带爬取的集合中,余下的内容就和爬取一个网页是相同的啦。不过这里需要注意的是,我们还需要一个记录已经爬取了的url的集合,这样当我们爬取一个网页的时候就从保存新增加的url的集合中取出该url,然后将其添加到已经爬取的url的集合,当我们在一个页面中发现新增加的url时就要考虑该url是否已将在待爬取的url集合中(表示该url和之前的某个url存在相互链接,导致该url已经添加到待爬取url集合中,因此不需要重复添加)或者在已经爬取的url集合中(表示该url已经爬取过)即:
if url['href'] not in new_urls and url['href'] not in crawed_urls:
其中的new_urls是新增加的待爬取的url集合,crawed_urls是已经爬取的url的集合,如果既不在新增加的url集合中也不在已经爬取的url集合中才说明该url需要爬取。这一块就是爬取全部相关网页的思路,我们先小结下重点:
- 分析多个url的格式,抽象出这些url的特点,一般会用正则表达式匹配
- 需要两个集合,一个用来保存每爬取一个页面后新增加的url,一个用来保存已经爬取了的url
- 新增加的url既不在保存新增加的url集合new_urls中也不在已经爬取了的url集合crawed_urls中才表示该url需要被爬取,因此我们将其添加到保存新增加的url集合new_urls中,供下一轮爬取使用
- 重复上述过程,直至新增加的url集合new_urls中的url被全部爬取为止,此时意味着全部的相关网页爬取完成。
现在我们来开始爬取和心仪妹子相关的全部网页的美图吧,是不是很激动,哈哈!代码如下:
import re
import os
import urllib2
from bs4 import BeautifulSoup

root_url = 'http://iyangzi.com/?p=21'
new_urls = set() #新增加的url集合
crawed_urls = set() #已经爬取的url的集合
count = 1

girl_dir = 'C:\Users\htq\Desktop\girl_'
if not os.path.exists(girl_dir):
    os.mkdir(girl_dir)
os.chdir(girl_dir)

new_urls.add(root_url)#添加待爬取的起始url
while len(new_urls) != 0:
        new_url = new_urls.pop()
        crawed_urls.add(new_url)
        print new_url
        try:
            response = urllib2.urlopen(new_url)
            if response.getcode() == 200:
                soup = BeautifulSoup(response.read(), 'html.parser', from_encoding='utf-8')

                #找到该页指向其它页面的且是新出现的url,添加到new_urls集合中供下一轮爬取
                urls = soup.find_all('a', href=re.compile(r"http://iyangzi.com/\?p=\d+$"))
                for url in urls:
                    #print url['href']
                    if url['href'] not in new_urls and url['href'] not in crawed_urls:
                        new_urls.add(url['href'])

                all_img = soup.find('div', class_='post-content').find_all('img')
                for img in all_img:
                    src = img['src']
                    # print src
                    name = 'iyangzi_' + str(count)
                    with open(name + '.jpg', 'ab') as img_object:
                        img_content = urllib2.urlopen(src).read()
                        img_object.write(img_content)
                        img_object.flush()
                    count += 1

        except urllib2.URLError, e:
            print e
程序代码注释很详细,相信大家都看的懂,主要是在上一节内容的基础上添加了爬取全部网页的内容,结合上面的小结和代码估计大家一会就看明白了,然后运行程序,在磁盘的C:\Users\htq\Desktop\girl_目录下就会自动保存心仪的妹纸图哦,如图:
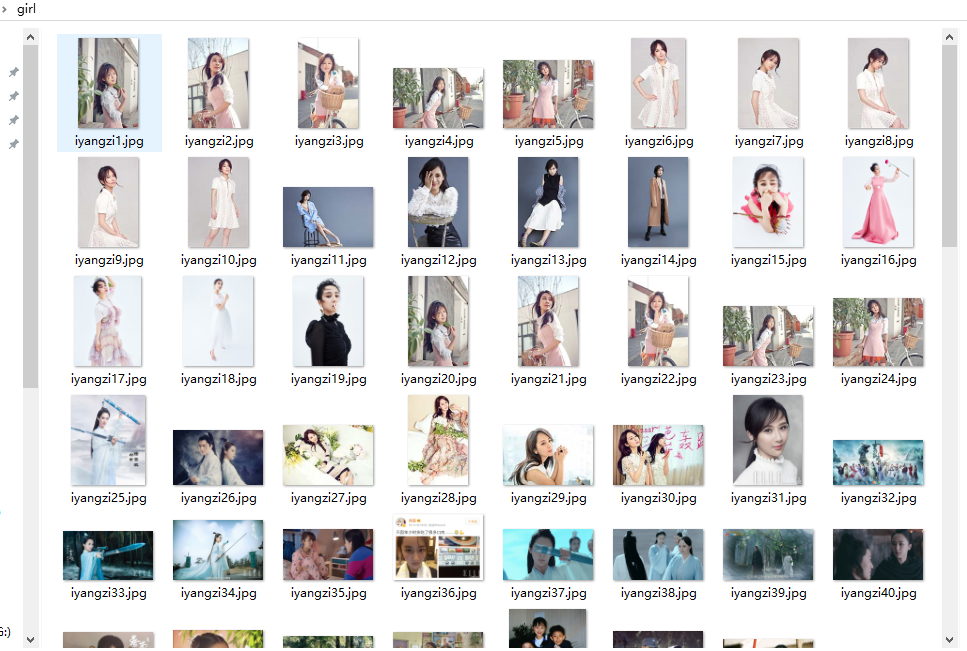
图片太多,只截了一页的图,哈哈,心仪的妹纸已经到碗里了,赶快去看看吧!
这样就完成了爬取全部相关网页的功能啦,在前一节中说过爬虫远不止这么简单,如某些网站会进行反爬虫,因此面对这种情况我们需要应对反爬虫,如使用多线程或者多进程提高效率,如本实例中会通过文件操作的方式将从网页上爬取的妹纸图片保存到本地,这相对而言是很耗时的,因此我们可以放到一个线程中进行处理,再如使用爬虫框架等等,这些内容将会以爬虫系列的形式进行讲解,希望大家后期继续关注,多多支持!
注:本文首次发表于huqi.tech,请勿转载,如需转载,请注明出处:huqi.tech

文章评论
写的非常棒学习了很多 ,笔者辛苦了,代码里少了import re 了
@alex 多谢提醒,可能是从IDE中复制已经写好的代码时给漏掉了,现在已经加上了,如果觉得写的不错的话,欢迎持续关注我的个人网站www.huqi.tech和我的微信公众号哦!
博主用的是虚拟主机还是云服务器,哪家的?我也想做个小博客。先谢谢了
@沉默是金 用的虚拟主机,谷歌的,因为我自己刚建这个网站时也是学生,没多少钱,谷歌可以免费试用1年。