在前面的几篇文章中,我带领大家学习了爬虫的基本理论知识,同时带领大家学会了如何爬取自己心仪的妹纸图,现在对前面的内容做个总结,把爬虫的一些知识点抽取出来做一个简单的爬虫架构的分析。之所以这么做是为了后面带领大家使用分析爬虫框架时更容易明白,在后面讲解scrapy爬虫框架时大家会发现scrapy的基本组件与原理与这个几乎一模一样,只不过我们这个很简单而已。
在超级易懂爬虫系列之爬虫入门爬取妹子图 中(如果你还没看的话建议先去看一下)我们谈到爬虫是从一个网页开始不断爬取与之关联的url,然后抓取我们感兴趣的数据,那么首先就需要抓取网页,然后解析网页的内容,这样才能找出我们感兴趣的内容,同时还需要知道哪些网页已经爬取过了,哪些网页未爬取,因为网页之间的url可能会互相指向,因此要保存那些已经爬取了的url,爬取过的就不在爬取,同时新爬取的网页上可能存在指向新的网页的url,因此需要把新的url保存起来用来下一轮进行爬取。因此我们可以总结出爬虫至少需要以下三个模块。
- 网页下载器:用来将互联网上的网页以html的形式抓取下来
- 网页解析器:从抓取到的html文件中解析出我们感兴趣的数据
- url管理器:用来管理哪些url是已经爬取过的,哪些是新增加的未爬取的url
用图示表示如下:
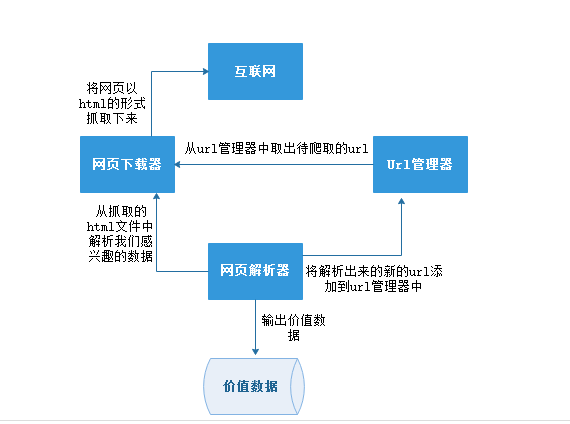
从这个图中,我们可以看到网页下载器,网页解析器,Url管理器组成了一个闭环,即程序中肯定存在一个while循环,在这个循环中,网页下载器不断的从Url管理器中取出一个待爬取的url,然后将该url的内容抓取下来,供网页解析器解析,网页解析器一方面会解析出我们感兴趣的数据,如妹纸图的下载地址,然后我们可以将其处理输出,产生价值数据,如将妹纸图下载下来保存至本地欣赏,另一方面网页解析器也会从当前url对应的html文件中解析出新的符合我们规则的新的url,如该妹纸图页面还存在指向其它页面的链接,如上一页,下一页可以浏览其它妹纸图,我们需要将新产生的url添加到url管理器中,在这个添加的过程中,需要判断该新产生的url是否是已爬取的(说明该url已经被抓取过)或者是否已经在Url管理器中(说明之前的某个页面存在指向该页面的url,导致该url已将添加到了url管理器中,不过还未爬取而已),如果该url未爬取同时也不在url管理器集合中,那么说明该url是一个合格的新的url,需要将其添加到url管理器中,重复上述过程(即while循环)直至url管理器中的url全部被取出为止,说明相关联的网页已经全部爬取完成。
这就是爬虫一个简单的架构,那么我们就按照上述架构来改写我们在超级易懂爬虫系列之爬取全部页面的妹子图中写的代码。
首先我们创建一个spider_girl的python工程,然后依此创建html_downloader.py,html_parser.py,url_manager,spider_main分别代表上面说到的网页下载器,网页解析器和url管理器以及爬虫主程序。如图:
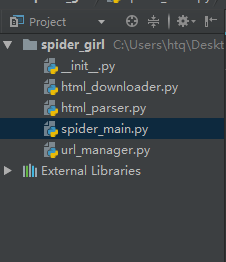
其中spider_main是整个爬虫的调度模块,主要负责构建上面三个模块的实例以及网页爬取循环的控制,代码如下:
# -*- coding: UTF-8 -*-
import os
import urllib2
from urllib2 import URLError
import url_manager, html_downloader, html_parser


class SpiderMain(object):

    def __init__(self):
        self.urls = url_manager.UrlManager()
        self.downloader = html_downloader.HtmlDownloader()
        self.parser = html_parser.HtmlParser()

    def craw(self, root_url):
        self.urls.add_new_url(root_url)
        count = 1
        girl_dir = 'C:\Users\htq\Desktop\girl'
        if not os.path.exists(girl_dir):
            os.mkdir(girl_dir)
        os.chdir(girl_dir)
        while self.urls.has_new_url():
            try :
                new_url = self.urls.get_new_url()
                print new_url
                html_cont = self.downloader.download(new_url)
                new_urls, img_srcs = self.parser.parse(new_url, html_cont)
                self.urls.add_new_urls(new_urls) #将爬取的新的url添加到待爬取的url集合中

                #保存获取到的妹子图
                for img in img_srcs:
                    src = img['src']
                    # print src
                    name = 'iyangzi' + str(count)
                    with open(name + '.jpg', 'ab') as img_object:
                        img_content = urllib2.urlopen(src).read()
                        img_object.write(img_content)
                        img_object.flush()

                    count += 1
            except URLError,e:
                print 'spider craw failed ',e

if __name__ == "__main__":
    root_url ="http://iyangzi.com/?p=21"
    obj_spider = SpiderMain()
    obj_spider.craw(root_url)
其中while循环部分是该模块的核心,核心思想和前面一节讲解的是一样的。
html_downloader.py模块负责从传入的url中将网页以html的形式抓取下来,功能很简单,因此代码很简单,如下:
# -*- coding: UTF-8 -*-
import urllib2

class HtmlDownloader(object):

    def download(self, url):
        if url is None:
            return None
        response = urllib2.urlopen(url)
        if response.getcode() != 200:
            return None
        return response.read()
经过前面两篇文章理论与动手操作相信大家很容易看懂这段代码了,和前面是一样的。
html_parser.py模块主要负责从传入的url参数中解析出我们感兴趣的数据和新增加的url,代码如下:
# -*- coding: UTF-8 -*-
import re
from bs4 import BeautifulSoup


class HtmlParser(object):

    def parse(self, page_url, html_cont):
        if page_url is None or html_cont is None:
            return
        #print html_cont
        soup = BeautifulSoup(html_cont, 'html.parser', from_encoding='utf-8')
        new_urls = self.get_new_urls(soup)
        img_srcs = self.get_img_data(soup)
        return new_urls, img_srcs

    def get_new_urls(self,soup):
        new_urls = set()
        links = soup.find_all('a', href=re.compile(r"http://iyangzi.com/\?p=\d+$"))
        for link in links:
            new_urls.add(link['href'])
        return new_urls

    def get_img_data(self,soup):
        img_srcs = []
        all_img = soup.find('div', class_='post-content').find_all('img')
        for img in all_img:
            img_srcs.append(img)
        return img_srcs
一般在解析出新的url时需要用到正则表达式,因为需要抽象出我们感兴趣的url的共同点,从而过滤掉不相关网页,只爬取我们需要的网页。这在前面文章中已经为大家分析过了。
url管理器主要负责判断哪些url已经访问过,哪些url虽然未访问但是已经在待爬取的url集合中。
# -*- coding: UTF-8 -*-

class UrlManager(object):
    def __init__(self):
        self.new_urls = set()    #新增加的待爬取的url集合
        self.crawed_urls = set() #已爬取的url集合

    def add_new_url(self, url):
        if url is None:
            return
        if url not in self.new_urls and url not in self.crawed_urls:
            self.new_urls.add(url)

    def add_new_urls(self, urls):
        if urls is None or len(urls) == 0:
            return
        for url in urls:
            self.add_new_url(url)

    def has_new_url(self):
        return len(self.new_urls) != 0

    def get_new_url(self):
        # 爬取一个url时将该url添加到已访问的url集合中表示该url已经访问过
        new_url = self.new_urls.pop()
        self.crawed_urls.add(new_url)
        return new_url
代码很简单,注释也很详细。
然后运行spider_main模块,可以看到和之前的效果是一样的,在程序控制台输出了所有的相关的妹纸图的url,在磁盘的C:\Users\htq\Desktop\girl目录下自动保存了心仪的妹纸图。
可以看到核心代码和我们在超级易懂爬虫系列之爬取全部页面的妹子图中讲解的是一样的,只不过此处根据各个模块的功能将其单独抽象为了一个类,然后提供了相应的功能函数,但是核心思路还是我们在前面讲到的架构图,此处将其抽象出来主要是为了后续更容易扩展其功能,如我们还可以将spider_main模块中的数据处理的那块再抽象出来搞一个数据输出模块output_data.py,这样如果后续需要将文件读写放到线程中时很容易直接改写output_data.py的代码,而不需要过多的改写spider_main中的代码。另一方面是为后面带领大家玩scrapy框架时大家能够更容易明白,在后面讲解scrapy爬虫框架时大家会发现scrapy的基本组件与原理与这个几乎一模一样,只不过我们这个很简单而已。
更多关于爬虫的干货,请继续关注超级易懂爬虫系列!
注:本文首次发表于huqi.tech,请勿转载,如需转载,请注明出处:huqi.tech

文章评论
教程很良心,把这个系列学完!